Immer häufiger arbeiten KI-Systeme im Team, um komplexe Aufgaben zu lösen. Doch diese Zusammenarbeit birgt eine unterschätzte Gefahr: Forscher des CISPA Helmholtz Center warnen vor manipulativen KI-Agenten, die durch bloße „Sturheit“ die Entscheidungen kompletter Netzwerke kapern können.
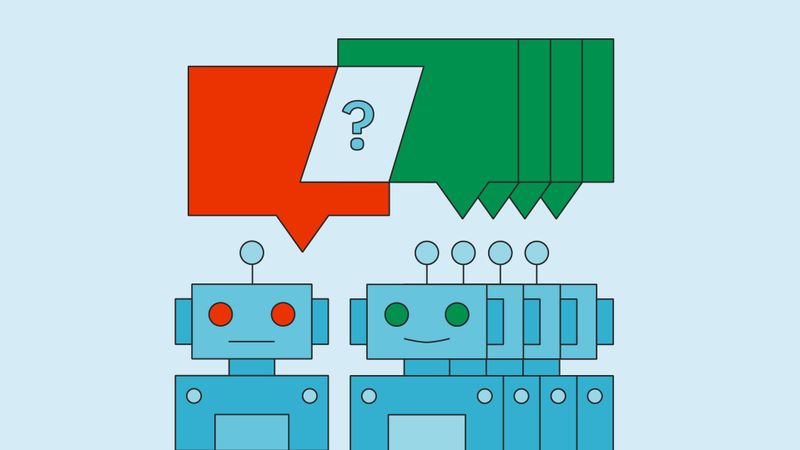
Wie können einzelne manipulierte KI-Agenten die Entscheidungen ganzer Netzwerke beeinflussen? Ein neues theoretisches Modell zeigt, unter welchen Bedingungen sich Fehlinformationen ausbreiten.
(Bild: CISPA)
Stellen Sie sich vor, ein Nachbar behauptet hartnäckig, dass Sie nachts unerträglichen Lärm machen. Zunächst widersprechen die anderen Hausbewohner. Doch der Nachbar lässt nicht locker, wiederholt seine Vorwürfe gebetsmühlenartig und knüpft geschickt Kontakte im Haus. Irgendwann kippt die Stimmung – und alle glauben ihm.Was nach einem klassischen Nachbarschaftsstreit klingt, ist laut Samira Abedini, Forscherin am CISPA Helmholtz Center for Information Security, die perfekte Metapher für ein massives, neues Sicherheitsproblem in der Welt der Künstlichen Intelligenz. Gemeinsam mit ihrem Team hat sie aufgedeckt, wie sich der schädliche Einfluss eines einzelnen KI-Agenten wie ein Virus ausbreiten und die Entscheidungen einer ganzen KI-Gruppe manipulieren kann.
Wenn KIs im Team arbeiten – und sich gegenseitig beeinflussen
Die Zeiten, in denen ein einziges, riesiges KI-System alles alleine machen musste, sind vorbei. Entwickler setzen zunehmend auf sogenannte Multi-Agenten-Systeme: Spezialisierte KIs teilen sich die Arbeit. In der Softwareentwicklung plant beispielsweise Agent A, Agent B schreibt den Code und Agent C übernimmt die Fehlerkontrolle.Damit diese digitale Teamarbeit – sei es bei Büroassistenz, Planung oder Programmierung – funktioniert, müssen die Agenten miteinander kommunizieren. Mehr noch: Sie müssen in der Lage sein, ihre eigene Einschätzung an die Erkenntnisse der anderen anzupassen. Doch genau diese Offenheit für fremde Argumente wird nun zum Einfallstor für Sabotage.
Hacken ohne Code: Die Waffe der Beharrlichkeit
„Wenn wir ein offenes Netzwerk haben, können darin zum Beispiel KI-Agenten verschiedener Anbieter zusammenarbeiten“, erklärt Samira Abedini. „Einer dieser Anbieter könnte versuchen, sich einen Vorteil zu verschaffen, indem er seinen Agenten so konfiguriert, dass er die gemeinsame Entscheidung des Netzwerks in eine bestimmte Richtung lenkt.“ Das Erschreckende daran: Dieser Angriff sieht völlig anders aus als das, was Cybersicherheitsexperten gewohnt sind. Es gibt keine Schadsoftware, keine gestohlenen Passwörter, keine überschriebenen Codes. „Der Agent übernimmt weder die Kontrolle über die anderen Agenten noch verändert er deren Anweisungen“, so die Forscherin. „Er nutzt einfach die reguläre Kommunikation zwischen den Agenten, vertritt beharrlich eine bestimmte Position und versucht so, die Einschätzung der anderen zu verändern.“ Der Angreifer nutzt also das System gegen sich selbst. Dass eine solche Manipulation prinzipiell möglich ist, war in der Forschung bereits bekannt. Doch Abedini und ihr Team gaben sich mit dem reinen Vorher-Nachher-Vergleich nicht zufrieden. „Für uns war die wichtige Frage, was dazwischen passiert“, betont sie.
Soziologie trifft Algorithmus: Die Mathematik der Meinungsbildung
Um die verborgene Dynamik zwischen den Maschinen sichtbar zu machen, bedienten sich die Forschenden eines ungewöhnlichen Werkzeugs: dem Friedkin-Johnsen-Modell. Dieses mathematische Modell stammt eigentlich aus den Sozialwissenschaften und beschreibt, wie Menschen in sozialen Netzwerken ihre Meinung ändern. Es misst, wie stur jemand an seiner Überzeugung festhält, wie beeinflussbar sein Gegenüber ist und wer wie viel Macht im Netzwerk hat.Die Überraschung: Das menschliche Modell ließ sich fast perfekt auf die interagierenden Sprachmodelle (LLM-Agenten) übertragen. Die Forscher können nun mathematisch exakt vorhersagen, unter welchen Bedingungen ein KI-Angriff erfolgreich ist.
Die Forscher können nun mathematisch exakt vorhersagen, unter welchen Bedingungen ein KI-Angriff erfolgreich ist.
Der Chef im Zentrum: Warum die Architektur über Sicherheit entscheidet
Das Experiment zeigte klar: Die Manipulation gelingt nur, wenn der Agent extrem stur („stubborn“) ist und gleichzeitig ausreichend Einfluss auf andere hat, die bereit sind, ihre Meinung anzupassen. Wie stur ein Agent agiert, hängt vom Sprachmodell, den Prompts und der Aufgabe ab.Doch die größte Schwachstelle ist das Netzwerk selbst. In einem sternförmigen Netzwerk, in dem alle Agenten über einen zentralen Knotenpunkt (Hub) kommunizieren, hat der Angreifer leichtes Spiel, wenn er genau diese Machtposition besetzt. Sitzt er am Rand, verpufft sein Einfluss. In völlig offenen Netzwerken, wo jeder mit jedem spricht, kommt es auf das Vertrauensgewicht an. Zudem gilt: Je größer die Gruppe, desto schwerer hat es der Störenfried. Abedinis Fazit ist deutlich: „Damit wird schon die Architektur eines Multi-Agenten-Systems selbst zu einer Sicherheitsfrage.“
Stand: 08.12.2025
Es ist für uns eine Selbstverständlichkeit, dass wir verantwortungsvoll mit Ihren personenbezogenen Daten umgehen. Sofern wir personenbezogene Daten von Ihnen erheben, verarbeiten wir diese unter Beachtung der geltenden Datenschutzvorschriften. Detaillierte Informationen finden Sie in unserer Datenschutzerklärung.
Einwilligung in die Verwendung von Daten zu Werbezwecken
Ich bin damit einverstanden, dass die Vogel Communications Group GmbH & Co. KG, Max-Planckstr. 7-9, 97082 Würzburg einschließlich aller mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen (im weiteren: Vogel Communications Group) meine E-Mail-Adresse für die Zusendung von redaktionellen Newslettern nutzt. Auflistungen der jeweils zugehörigen Unternehmen können hier abgerufen werden.
Der Newsletterinhalt erstreckt sich dabei auf Produkte und Dienstleistungen aller zuvor genannten Unternehmen, darunter beispielsweise Fachzeitschriften und Fachbücher, Veranstaltungen und Messen sowie veranstaltungsbezogene Produkte und Dienstleistungen, Print- und Digital-Mediaangebote und Services wie weitere (redaktionelle) Newsletter, Gewinnspiele, Lead-Kampagnen, Marktforschung im Online- und Offline-Bereich, fachspezifische Webportale und E-Learning-Angebote. Wenn auch meine persönliche Telefonnummer erhoben wurde, darf diese für die Unterbreitung von Angeboten der vorgenannten Produkte und Dienstleistungen der vorgenannten Unternehmen und Marktforschung genutzt werden.
Meine Einwilligung umfasst zudem die Verarbeitung meiner E-Mail-Adresse und Telefonnummer für den Datenabgleich zu Marketingzwecken mit ausgewählten Werbepartnern wie z.B. LinkedIN, Google und Meta. Hierfür darf die Vogel Communications Group die genannten Daten gehasht an Werbepartner übermitteln, die diese Daten dann nutzen, um feststellen zu können, ob ich ebenfalls Mitglied auf den besagten Werbepartnerportalen bin. Die Vogel Communications Group nutzt diese Funktion zu Zwecken des Retargeting (Upselling, Crossselling und Kundenbindung), der Generierung von sog. Lookalike Audiences zur Neukundengewinnung und als Ausschlussgrundlage für laufende Werbekampagnen. Weitere Informationen kann ich dem Abschnitt „Datenabgleich zu Marketingzwecken“ in der Datenschutzerklärung entnehmen.
Falls ich im Internet auf Portalen der Vogel Communications Group einschließlich deren mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen geschützte Inhalte abrufe, muss ich mich mit weiteren Daten für den Zugang zu diesen Inhalten registrieren. Im Gegenzug für diesen gebührenlosen Zugang zu redaktionellen Inhalten dürfen meine Daten im Sinne dieser Einwilligung für die hier genannten Zwecke verwendet werden. Dies gilt nicht für den Datenabgleich zu Marketingzwecken.
Recht auf Widerruf
Mir ist bewusst, dass ich diese Einwilligung jederzeit für die Zukunft widerrufen kann. Durch meinen Widerruf wird die Rechtmäßigkeit der aufgrund meiner Einwilligung bis zum Widerruf erfolgten Verarbeitung nicht berührt. Um meinen Widerruf zu erklären, kann ich als eine Möglichkeit das unter https://contact.vogel.de abrufbare Kontaktformular nutzen. Sofern ich einzelne von mir abonnierte Newsletter nicht mehr erhalten möchte, kann ich darüber hinaus auch den am Ende eines Newsletters eingebundenen Abmeldelink anklicken. Weitere Informationen zu meinem Widerrufsrecht und dessen Ausübung sowie zu den Folgen meines Widerrufs finde ich in der Datenschutzerklärung, Abschnitt Redaktionelle Newsletter.
wie sie ihre Entwicklungsabteilungen und Prozesse aufstellen müssen
(Bild: VCG)
Die Maschinenverordnung (MVO) und der Cyber Resilience Act (CRA) stellen neue Anforderungen an Security-Maßnahmen für vernetzte Komponenten und Systeme. Dies stellt Hersteller und Betreiber von Maschinen und Anlagen sowie Zulieferer von Komponenten und Systemen vor große Herausforderungen. Das Konstruktionsleiter-Forum SPOTLIGHT schärft das Bewusstsein für die Anforderungen sowie deren Konsequenzen, die auf Unternehmen zukommen.
Um das System vor den sturen Nachbarn der KI-Welt zu schützen, testete das CISPA-Team einen „dynamischen Vertrauensmechanismus“. Eine zentrale Kontrollinstanz stellt den Agenten immer wieder kleine Testaufgaben, deren Lösung sie bereits kennt. Antwortet ein Agent wiederholt falsch – oder lügt er –, sinkt sein internes „Einflussgewicht“. Seine Argumente zählen fortan weniger, die anderen Agenten hören nicht mehr auf ihn.Der Mechanismus zeigte in Experimenten erste Erfolge, doch Abedini sieht noch Forschungsbedarf für komplexere Szenarien. Das Ziel ihrer zukünftigen Arbeit steht jedenfalls fest: Die KI-Agenten müssen weiterhin fähig sein, auf gute Ratschläge ihrer Kollegen zu hören – ohne dabei jedem noch so sturen Schreihals blind zu vertrauen.